Parsewise 的 RAG
02流水线
03架构
围绕同一个内核
每个节点只把一件事做好。 嵌入负责算语义,向量库负责检索,大模型负责挑片段 — 需要时还能亮出来源。
嵌入
1024 维语义空间
向量库
pgvector · 两个库
切片
文档片段
查询扩展
同义词与改写
同步
每天早上更新
片段筛选
模型自己挑
缓存
高频查询更快
来源
可选:展示文档
RAG
04准确度
按语义找,按事实答
模型不编 — 它引用。 找到的片段进入提示词,答案就建立在它们之上。没有片段时,助手会老实说不知道。
01
个维度。
为库里每个片段生成一个稠密语义向量。
02
个库。
商品目录和知识分开检索 — 上下文更准。
03
来自你的数据。
答案由检索到的片段拼成。
05速度
快,而且明天也不会变慢
库变大,向量检索几乎没感觉。 从一百份文档到数万份 — 响应时间只差几十毫秒。
01
检索 p95
语义检索,覆盖整个知识库
02
首个 token
答案立刻开始打字
03
文件入库
从上传到能作答
04
性能衰减
库增长了速度也稳住
06细节
准确度藏在细节里
好的 RAG 是一门抠细节的功夫。 查询扩展、老老实实地挑片段,以及按需给出原始出处。
/01
查询扩展
同义词和改写提高检索召回。
/02
由大模型挑片段
由模型决定哪些片段进入答案。
/03
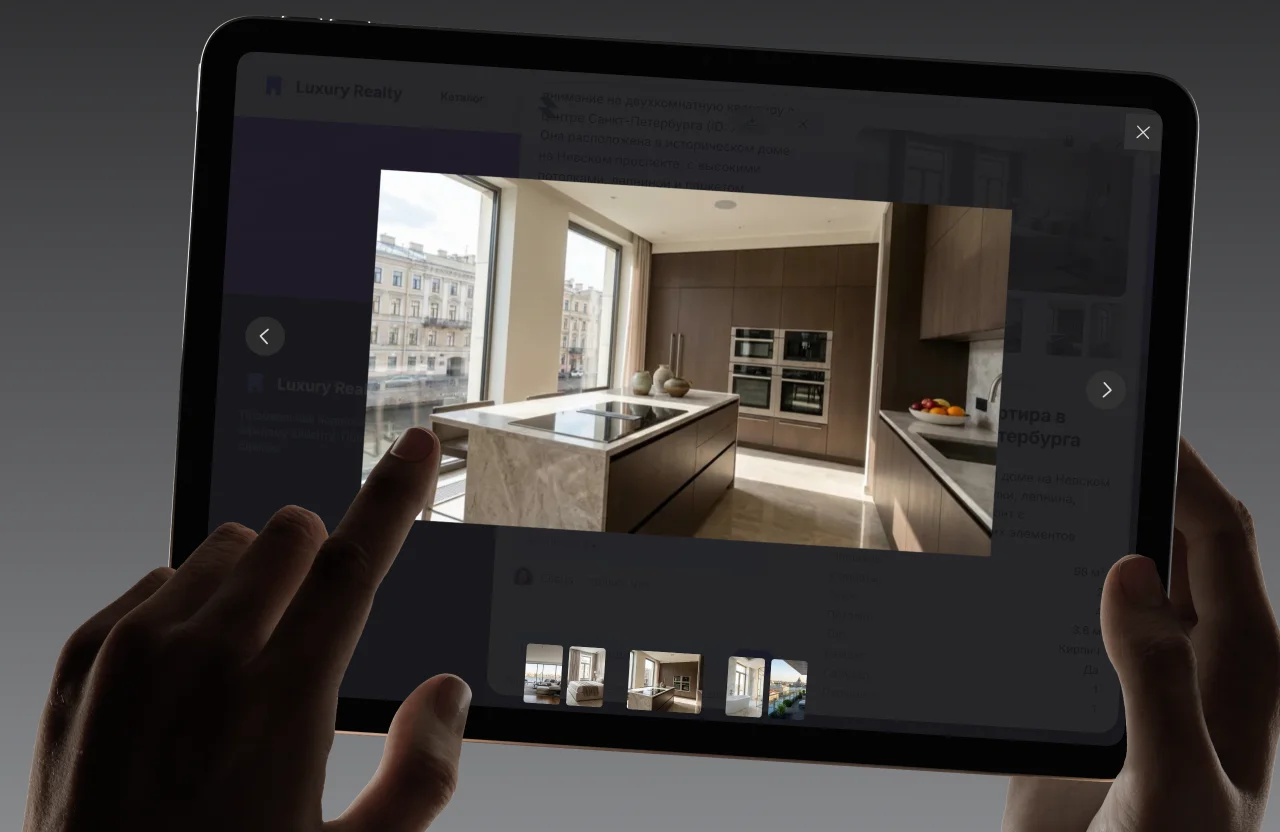
可选:展示文档
高亮的原文片段 — 一个开关的事。
07RAG
在你的数据上验证
检验 RAG 最好的办法,是拿你自己的文档。 传两个文件,问一个你自己知道答案的问题。
开始使用
用你自己的数据试一试
上传你的文档和商品目录,然后把别人问你的问题拿去问助手。 这是唯一有意义的检验。